Кейсы

Самые сложные задачи, которые я решал

LLM-агенты, GPU-инференс, хостинг агентов и синхронизация данных. В каждом кейсе: что ломалось, почему это было сложно, что я изменил и цифры до и после.

Тимлид платформы LUUK AI · магистратура по ИИ (в процессе) · Бали (UTC+8) · Готов к релокации

01Оценка LLM · Архитектура агентаLUUK AI · сен–окт 2026

Как тестировать LLM-агента, который никогда не отвечает одинаково

Набор из 310 тестов качества ответов на замороженных данных из продакшена, а затем переписанный агент, улучшение которого этот набор смог доказать.

9–13% → 0,2–0,5%
пустых ответов
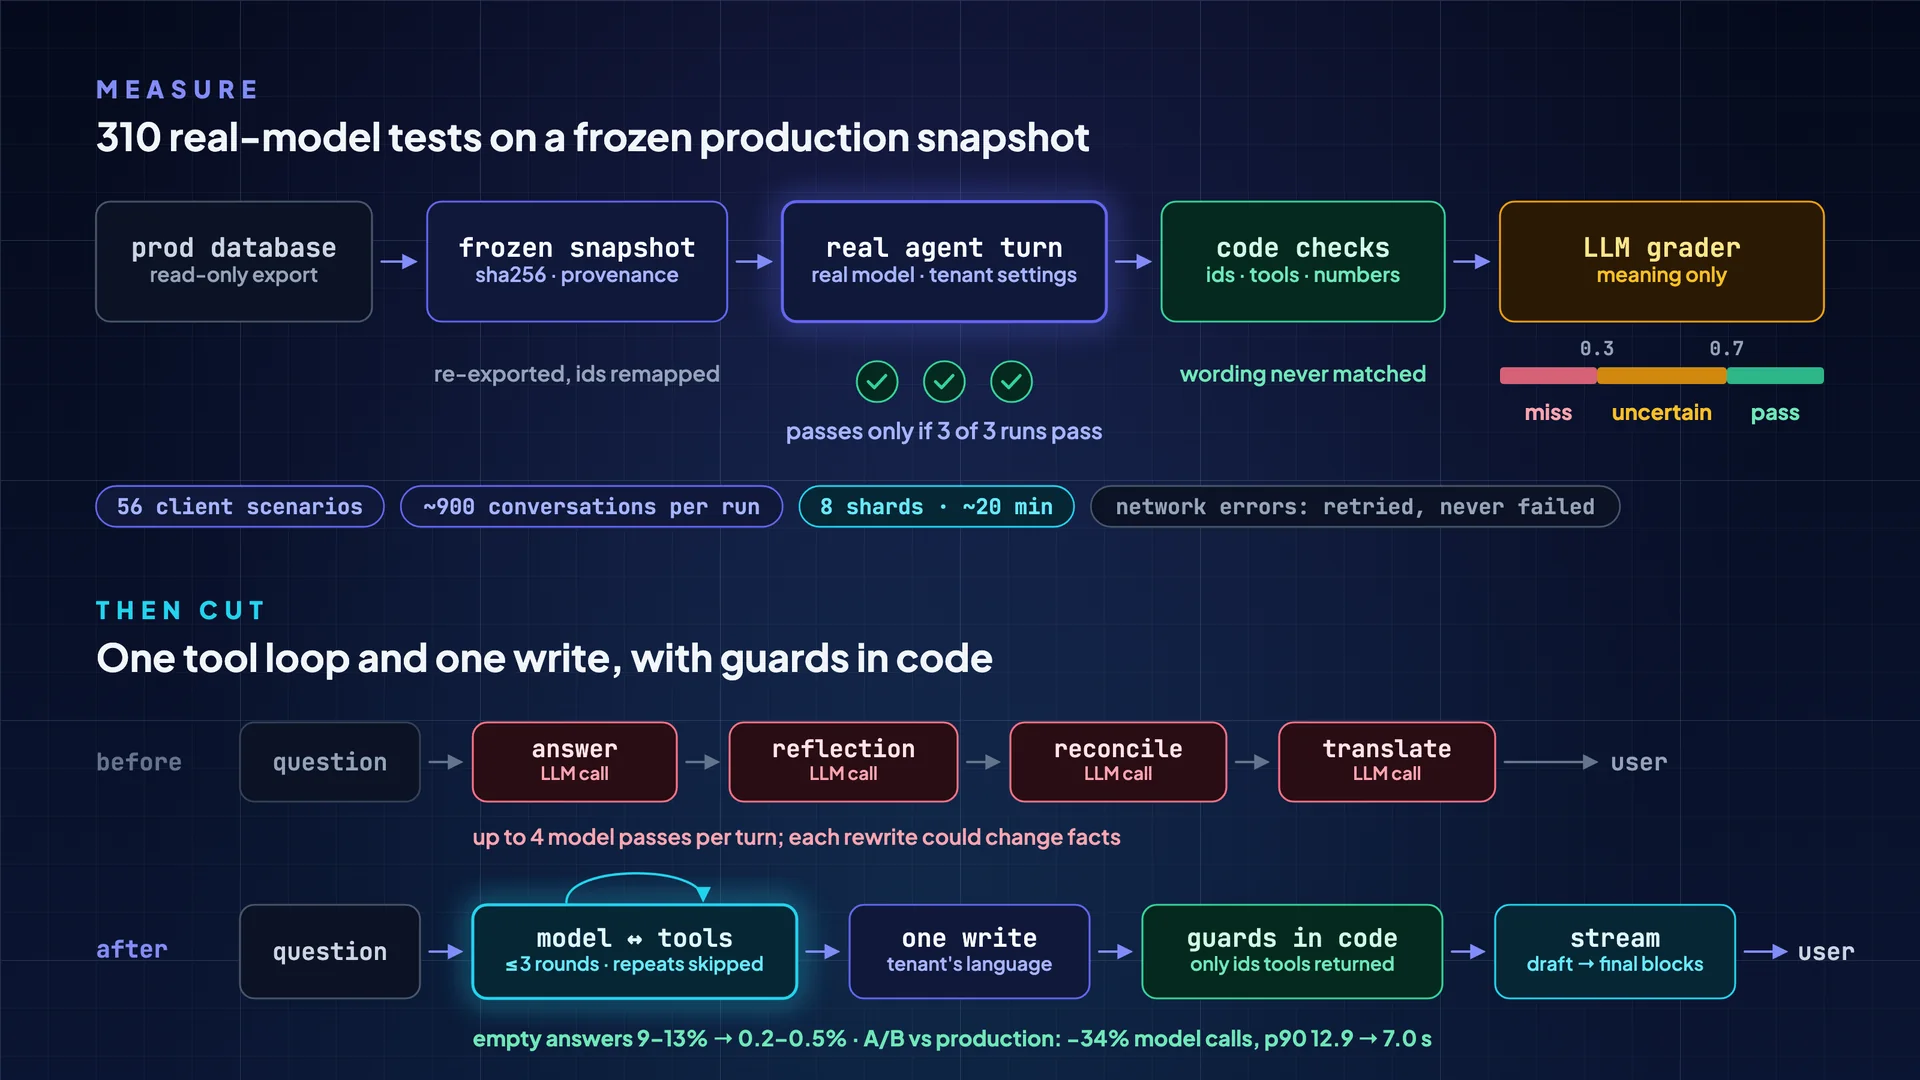
Сверху: база продакшена, замороженный снимок, настоящий ход агента в 3 запусках, проверки в коде и LLM-судья с зонами «провал», «не уверен» и «пройден». Снизу: раньше ответ и до трёх проходов LLM, переписывающих его; теперь цикл инструментов, одна запись, проверки в коде и потоковый ответ.Открыть схему в полном размере

Задача

Наши ассистенты продаж отвечают покупателям и брокерам, вызывая инструменты поверх живого каталога и базы знаний. После первого ответа ещё до трёх проходов LLM переписывали его (рефлексия, согласование, перевод), и каждый мог исказить факты. Понять, стали ли ответы после изменения лучше или хуже, было невозможно: старые тесты проверяли вспомогательные функции на старой выгрузке данных и оставались зелёными, пока агент был сломан.

Почему это было сложно

  • Один и тот же вопрос даёт разные ответы при каждом запуске, а разные модели по-разному используют инструменты.
  • Код не может оценить смысл ответа, а LLM-судья тоже ошибается.
  • Тест должен запускать агента ровно так, как он развёрнут, и на неизменных данных, хотя данные в продакшене меняются, а каждая пересинхронизация выдаёт новые id.
  • Полный прогон — это около 900 реальных диалогов, то есть реальные токены, и сетевые ошибки не должны считаться провалами.

Что я сделал

  1. 1Заморозил данные продакшена: выгрузки только на чтение, sha256 и происхождение для каждого файла. При обновлении закреплённые id переносятся на новые.
  2. 2Тест запускает настоящий ход агента на настоящей модели с настройками самого тенанта, и я проверил, что он совпадает с продакшеном. Сначала не совпадал: другой бюджет токенов, порог поиска и словарь.
  3. 3Сначала проверяет код (id, инструменты и числа, заранее вычисленные по снимку), а LLM-судья оценивает только смысл, с зоной «не уверен». Тест проходит, только если прошли все 3 запуска; формулировки никогда не сравниваются, а сетевые ошибки повторяются и не засчитываются как провал. Около 20 минут на 8 шардах.
  4. 4Затем переписал ход: цикл инструментов и одна запись ответа, проверки в коде (рекомендовать можно только id, которые вернули инструменты), бюджет раундов прямо в промпте и никаких запасных путей, скрывающих пустой ответ. A/B-тест против продакшена доказал это до мержа.

Результаты

310
тестов на реальной модели по 56 сценариям клиента, проходят только 3 из 3 запусков
9–13% → 0,2–0,5%
ходов с пустым ответом
−34%
вызовов модели против продакшена в A/B-тесте, 6 вопросов × 3 запуска (вызовов эмбеддингов −82%)
12,9 → 7,0 с
p90 задержки в том же A/B-тесте
Кто что делал: Набор тестов, его правила и переписывание агента — мои. Коллега перенёс сценарии клиента, многие тесты написали ИИ-агенты по моим правилам, поиск по каталогу — работа коллеги.

PYTHONFASTAPILANCEDBSQLITEGITHUB ACTIONSSSE
02GPU-инференс · Балансировка нагрузкиLUUK · сен 2026

Как подготовить GPU-API компьютерного зрения к запуску у партнёра

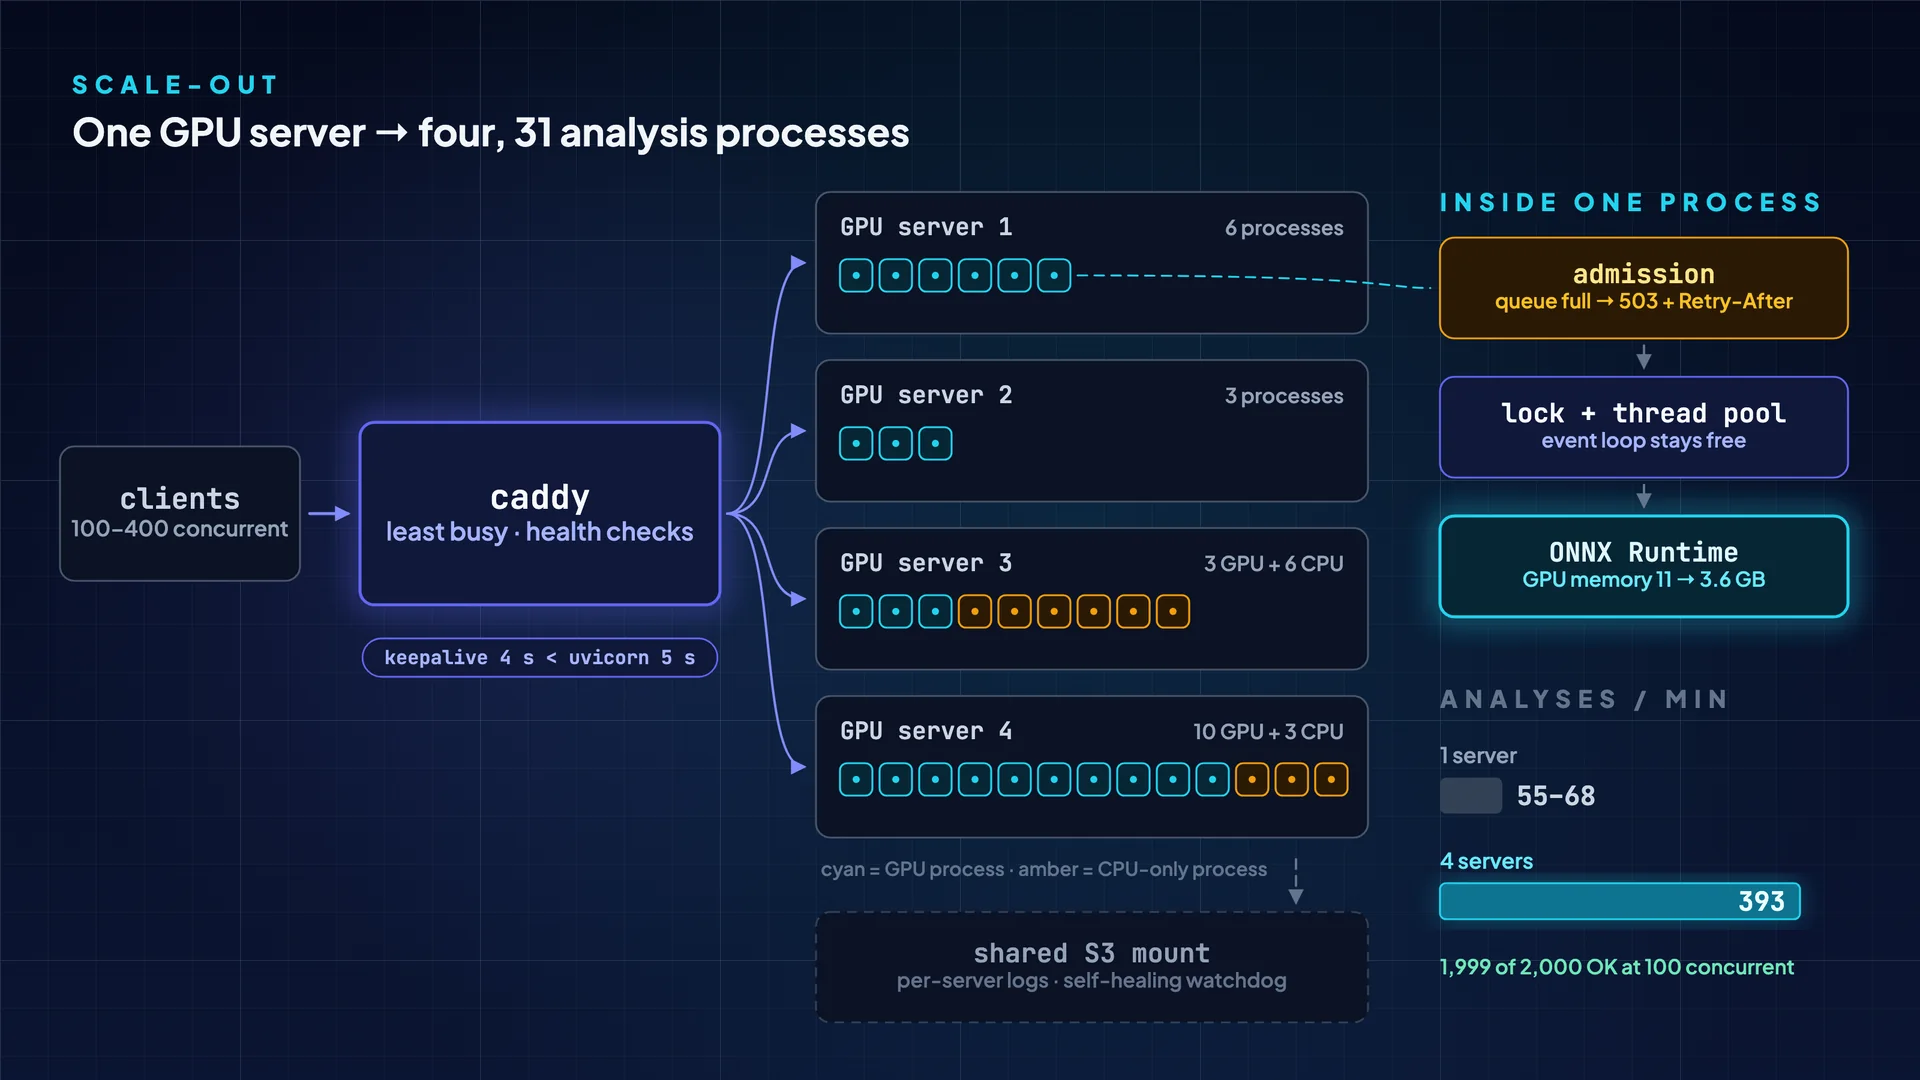
От сервиса, который падал в вечерний пик, до четырёх GPU-серверов и 393 анализов в минуту, с замерами через публичный адрес.

37% → 95%
пользователей с полным результатом
Клиенты, Caddy с маршрутизацией в наименее загруженный процесс, четыре GPU-сервера с 31 процессом анализа, часть только на CPU, общее S3-монтирование с watchdog. Врезка: очередь, блокировка и пул потоков, ONNX Runtime на 3,6 ГБ. Столбцы: 55–68 анализов в минуту на одном сервере, 393 на четырёх.Открыть схему в полном размере

Задача

API анализа кожи по фото лица (ONNX-модели команды за FastAPI) вот-вот должен был встроить крупный партнёр. Однажды в вечерний пик он уже отказал: прокси пометил оба бэкенда недоступными на 43 минуты, и результат получила примерно одна загрузка из пяти. Серверы не падали. Каждый анализ шёл 2,5–5 с в цикле событий единственного процесса, и тот не мог ответить на проверки здоровья.

Почему это было сложно

  • Состояние каждого фото жило в общих объектах модуля, поэтому просто распараллелить анализ внутри одного процесса было нельзя.
  • Поиск алгоритма cuDNN по умолчанию занимал около 11 ГБ памяти GPU на первом фото; два процесса, стартовавшие вместе, исчерпывали память.
  • Результаты лежали на общем S3-монтировании, которое кешировало «не найдено», а два сервера, дописывавшие один лог-объект, повесили целый сервер на 13 минут.
  • Разнородный парк, от T4 до двух A5000, и прокси, переиспользовавший соединения, которые uvicorn уже закрывал: 2–3% загрузок получали 502.

Что я сделал

  1. 1Поднял копию продакшена на простаивавшем резервном GPU-сервере (тот же код, конфиг и настройки прокси) и прогонял один и тот же поток запросов до и после каждого исправления.
  2. 2Вынес анализ в пул потоков с лимитом на процесс и ограниченной очередью, которая сразу отвечает 503 с Retry-After, — так проверки здоровья проходят всегда.
  3. 3Настроил CUDA-провайдер (эвристический поиск cuDNN, без максимального workspace, память растёт только по запросу) и рассчитал число процессов на GPU по измеренной памяти. Параллелизм внутри процесса давал +10–15% ценой +2,4 ГБ, поэтому я от него отказался.
  4. 4Один процесс на порт и маршрутизация в наименее загруженный, keep-alive короче таймаута uvicorn, а результаты запрашиваются у серверов по очереди. Отдельные логи для каждого сервера и watchdog, перемонтирующий S3 меньше чем за 2 минуты.

Результаты

37% → 95%
пользователей с полным результатом при той же нагрузке на копии продакшена (13% → 87% на пиковой интенсивности)
55–68 → 393
анализов в минуту через продакшен-адрес, 1 → 4 GPU-сервера
11 → 3,6 ГБ
памяти GPU на процесс; первый анализ 38 с → 2 с
1 999 / 2 000
успешных запросов при 100 одновременных клиентах

Кто что делал: Модели — работа команды. Диагностику, масштабирование и нагрузочные тесты вёл я вместе с ИИ-агентом для кода.

PYTHONFASTAPIONNX RUNTIMECUDACADDYSYSTEMD
03Платформа · Управление процессамиLUUK AI · мар–апр 2026

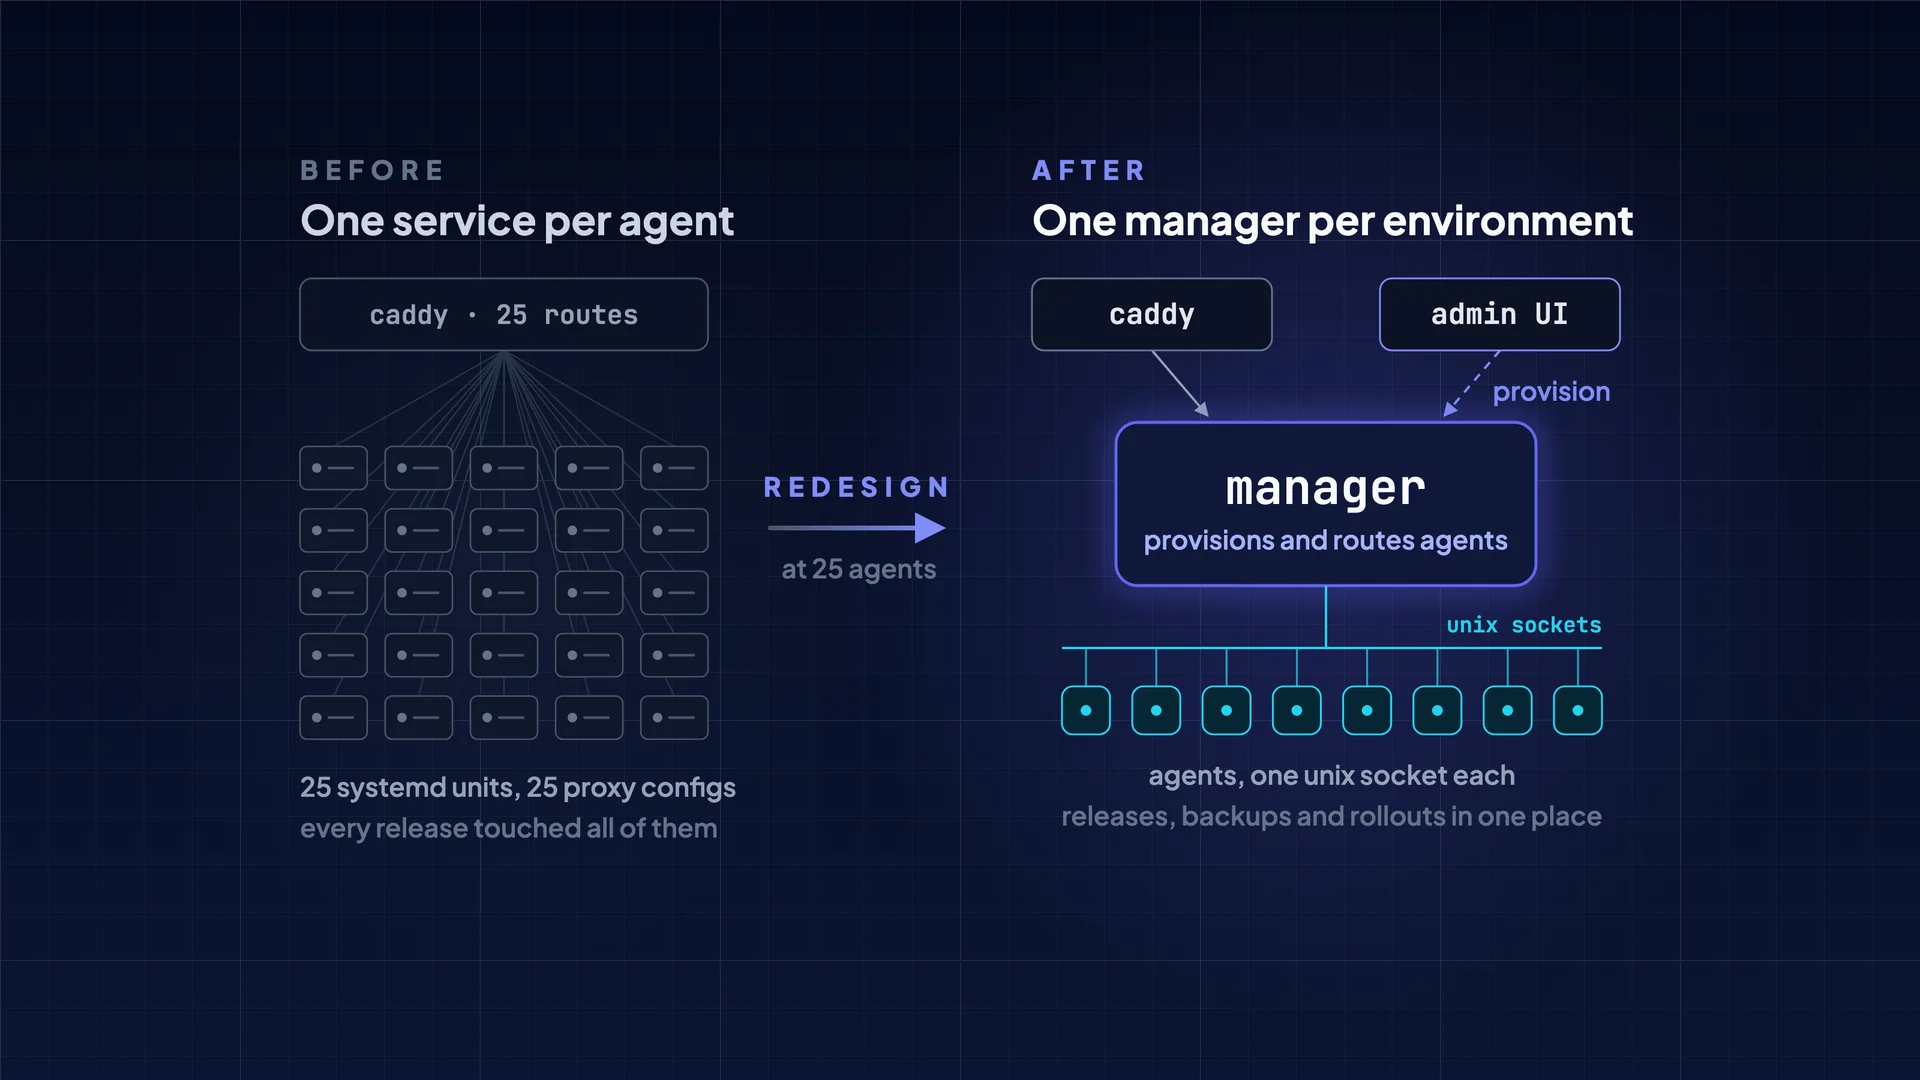
Один менеджер процессов вместо 25 сервисов агентов

Один менеджер на окружение запускает агента каждого партнёра на своём Unix-сокете. Я нашёл и убрал 3,5 с, которые он сначала добавлял, а затем переключил продакшен вживую.

25 → 1
сервисов на окружение
До и после: 25 сервисов агентов, у каждого свой маршрут в прокси, заменены одним менеджером на окружение, который создаёт агентов из админки и направляет к ним запросы через Unix-сокетыОткрыть схему в полном размере

Задача

Агент каждого партнёра был отдельным FastAPI-приложением, systemd-юнитом, TCP-портом и куском конфига прокси, который вручную копировался на пограничный сервер: пять ручных шагов на двух машинах на каждого агента и 25 сервисов только на основном сервере. При этом у каждого агента должны были остаться свой процесс, свои данные и настройки.

Почему это было сложно

  • Запускать, останавливать и перезагружать одного тенанта, не трогая остальных; крупные агенты стартуют до 2 минут.
  • Python-прокси теперь стоит перед каждым вызовом LLM. Первая версия добавляла около 3,5 с к каждому запросу.
  • Один процесс владеет всеми агентами, поэтому ошибка менеджера бьёт по всем тенантам. Одна очень длинная строка лога от дочернего процесса могла оборвать чтение логов и перезапустить агентов.
  • Переключение нужно было делать на продакшене с возможностью отката, и по ходу всплыли скрытые зависимости: секреты из файла по симлинку, расхождение конфигов, установка пакетов, убитая OOM killer, порт, всё ещё занятый старым сервисом.

Что я сделал

  1. 1Написал менеджер: каждый агент работает на своём Unix-сокете, упавшие агенты перезапускаются, а изменение конфига перезагружает только затронутых агентов. Новые агенты запускаются из админки.
  2. 2Убрал 3,5 с: потоковая передача вместо буферизации, агенты обращаются к сокету супервизора напрямую (4 прохода через прокси на запрос → 2) и uvloop.
  3. 3Сделал менеджер живучим: чтение логов ограничивает строки без перевода строки и никогда не падает, перезапуск через 3 с, а остановка сначала завершает процесс, ждёт 10 с и только потом убивает.
  4. 4Провёл переключение продакшена по плану с откатом. Оно вскрыло 13 агентов, отключённых в базе, но всё ещё работающих; синхронизация файла агентов из админки закрыла эту проблему насовсем.

Результаты

25 → 1
сервисов агентов → один менеджер на окружение, сейчас на 3 серверах
5 → 1
ручных шагов для запуска агента (теперь одна форма в админке)
~3,5 с → шум
накладные расходы прокси на запрос, найдены и убраны
2,9 → 9,9 ГиБ
свободной памяти после остановки 13 забытых агентов

Кто что делал: Менеджер — мой (14 из 14 коммитов). До этого коллега сделал небольшой прототип маршрутизации.

PYTHONASYNCIOUVLOOPHTTPXUNIX SOCKETSSYSTEMD
04Бэкенд · Согласованность данныхБрокерская платформа (до запуска) · 2026

Синхронизация с чужой CRM без потерянных обновлений

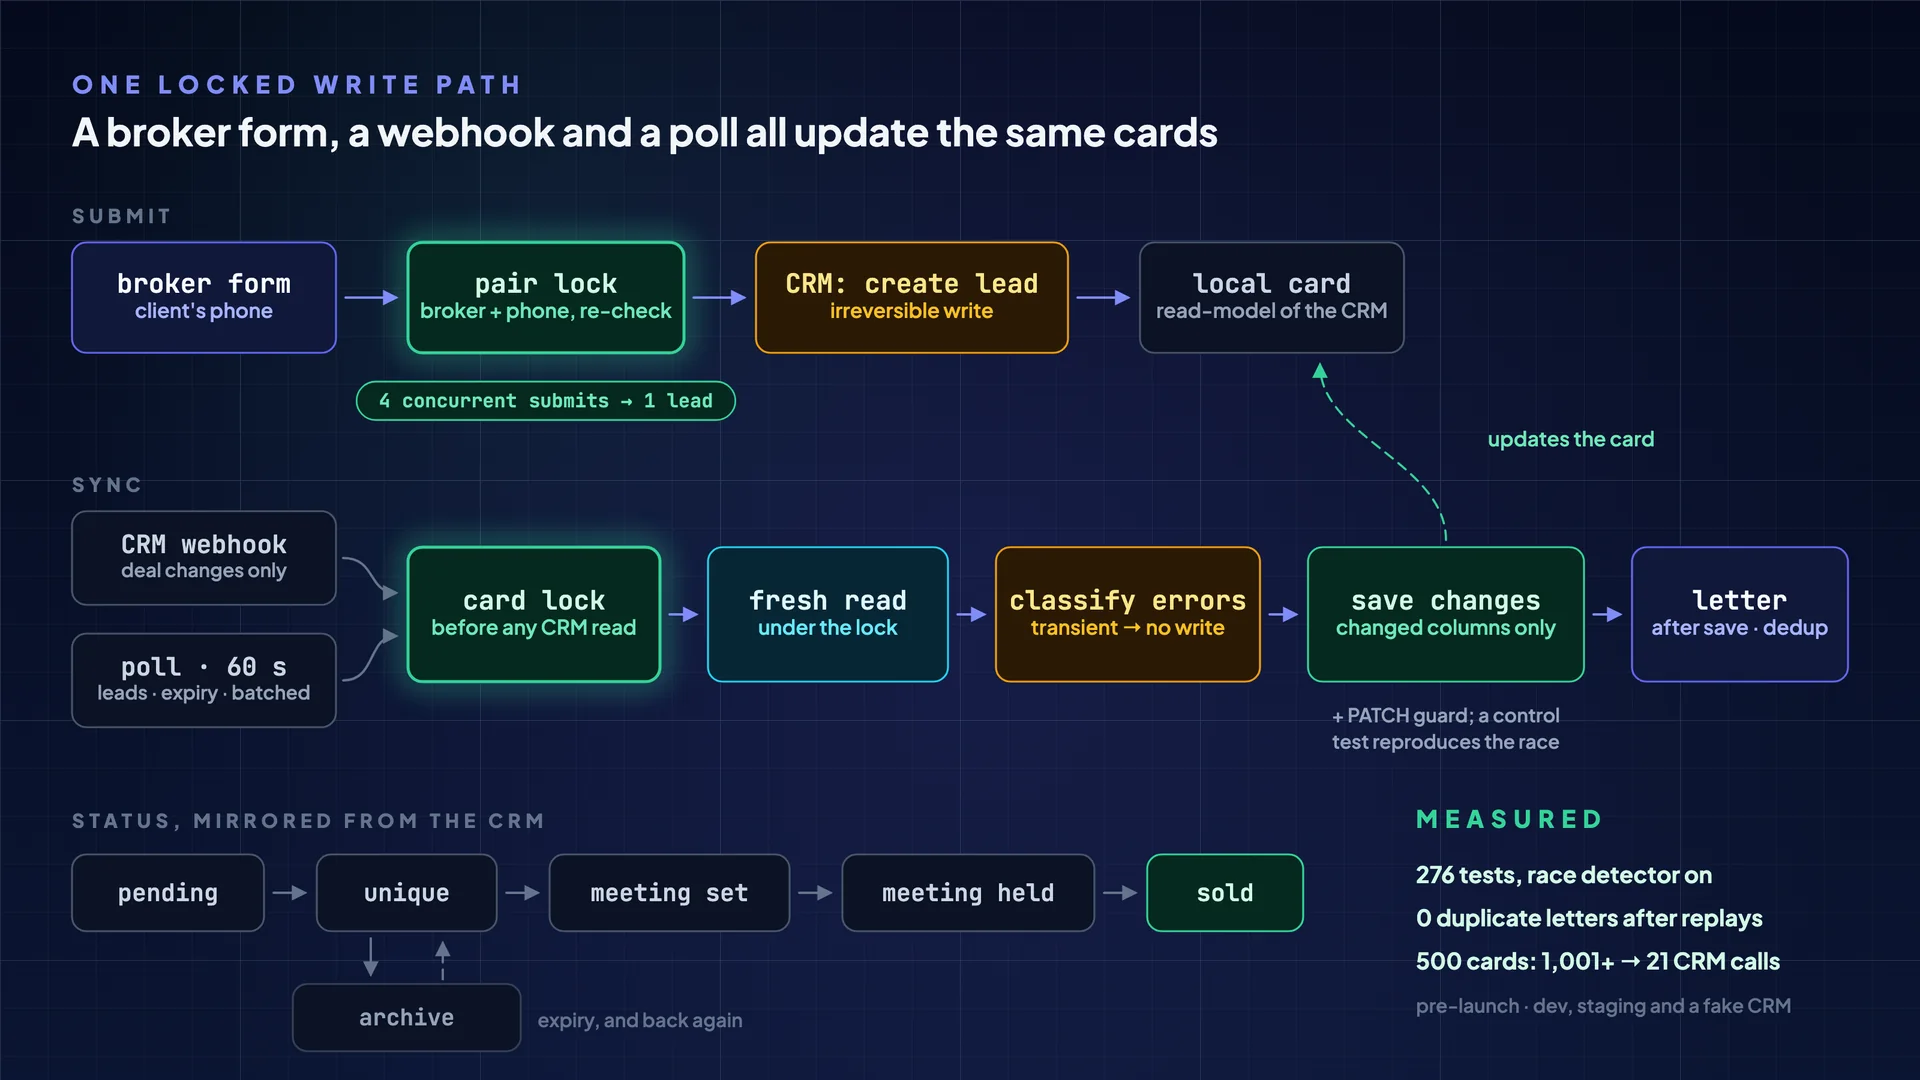
Форма брокера, вебхук и опрос пишут в одни и те же карточки; один путь записи под блокировкой держит их согласованными.

4 → 1
одновременные отправки → лиды в CRM
Отправка: форма брокера, блокировка пары, лид в CRM, локальная карточка. Синхронизация: вебхук и опрос, блокировка карточки, свежее чтение, классификация ошибок, сохранение изменённых колонок, письмо. Внизу: статусы карточки, отражённые из CRM.Открыть схему в полном размере

Задача

Брокер регистрирует в приложении телефон клиента. Бэкенд должен создать лид в Bitrix24 CRM клиента, создать локальную карточку и держать её статус (ожидает, уникален, встреча назначена, встреча проведена, продано или в архиве) в соответствии с тем, что делают менеджеры в CRM: без дублей лидов, потерянных записей и повторных писем брокерам.

Почему это было сложно

  • Для половины жизненного цикла нет событий: вебхук сообщает только об изменениях сделок, поэтому лиды и истечение сроков нужно опрашивать, и опрос с вебхуком гоняются за одну карточку.
  • Записи в CRM клиента необратимы. CRM ограничивает частоту запросов, одно обновление заняло 24 с, а пользователь интеграции перестаёт видеть сделки, потерявшие наблюдателей.
  • API записей во фреймворке сохраняет все загруженные колонки, поэтому правка комментария брокером могла откатить смену статуса.
  • Процесс клиента прошёл семь версий за 17 дней.

Что я сделал

  1. 1Блокировка на пару «брокер + телефон» с повторной проверкой дубля под ней: в тесте 4 одновременные отправки создают ровно один лид.
  2. 2Каждая синхронизация берёт блокировку карточки до чтения из CRM, а пакетная предвыборка используется, только если более свежее чтение этой карточки ещё не завершилось. Вебхук сначала смотрит в локальную базу, поэтому чужие сделки больше не падают.
  3. 3Сохраняются только изменённые колонки, плюс защита в API записей. Контрольный тест воспроизводит потерю обновления без этой защиты.
  4. 4Временные ошибки CRM ничего не записывают; при ограничении частоты запросы повторяются через 1, 2 и 4 с; письма планируются по состоянию до и после и отправляются только после успешного сохранения.

Результаты

42%
вызовов вебхука падали на стейджинге до исправления (808 из 1 934); теперь 500 только при сбое локального сохранения
1 001+ → 21
запрос к CRM, чтобы опросить 500 карточек (тестовая CRM)
0
повторных писем после перезапуска и 4 повторённых вебхуков на живой CRM
276
тестов в пакете синхронизации, с детектором гонок

Кто что делал: Я единственный бэкенд-разработчик и делал это вместе с ИИ-ассистентами для кода: план и условия релизов задавал я, тесты с детектором гонок запускал сам. Приложение — работа другого разработчика, приёмку проводили сотрудники клиента.

GOPOCKETBASESQLITEBITRIX24 REST
05LLM-приложения · Личный проектAgent Coach · май 2026

Долгосрочная память, которую LLM не может выдумать

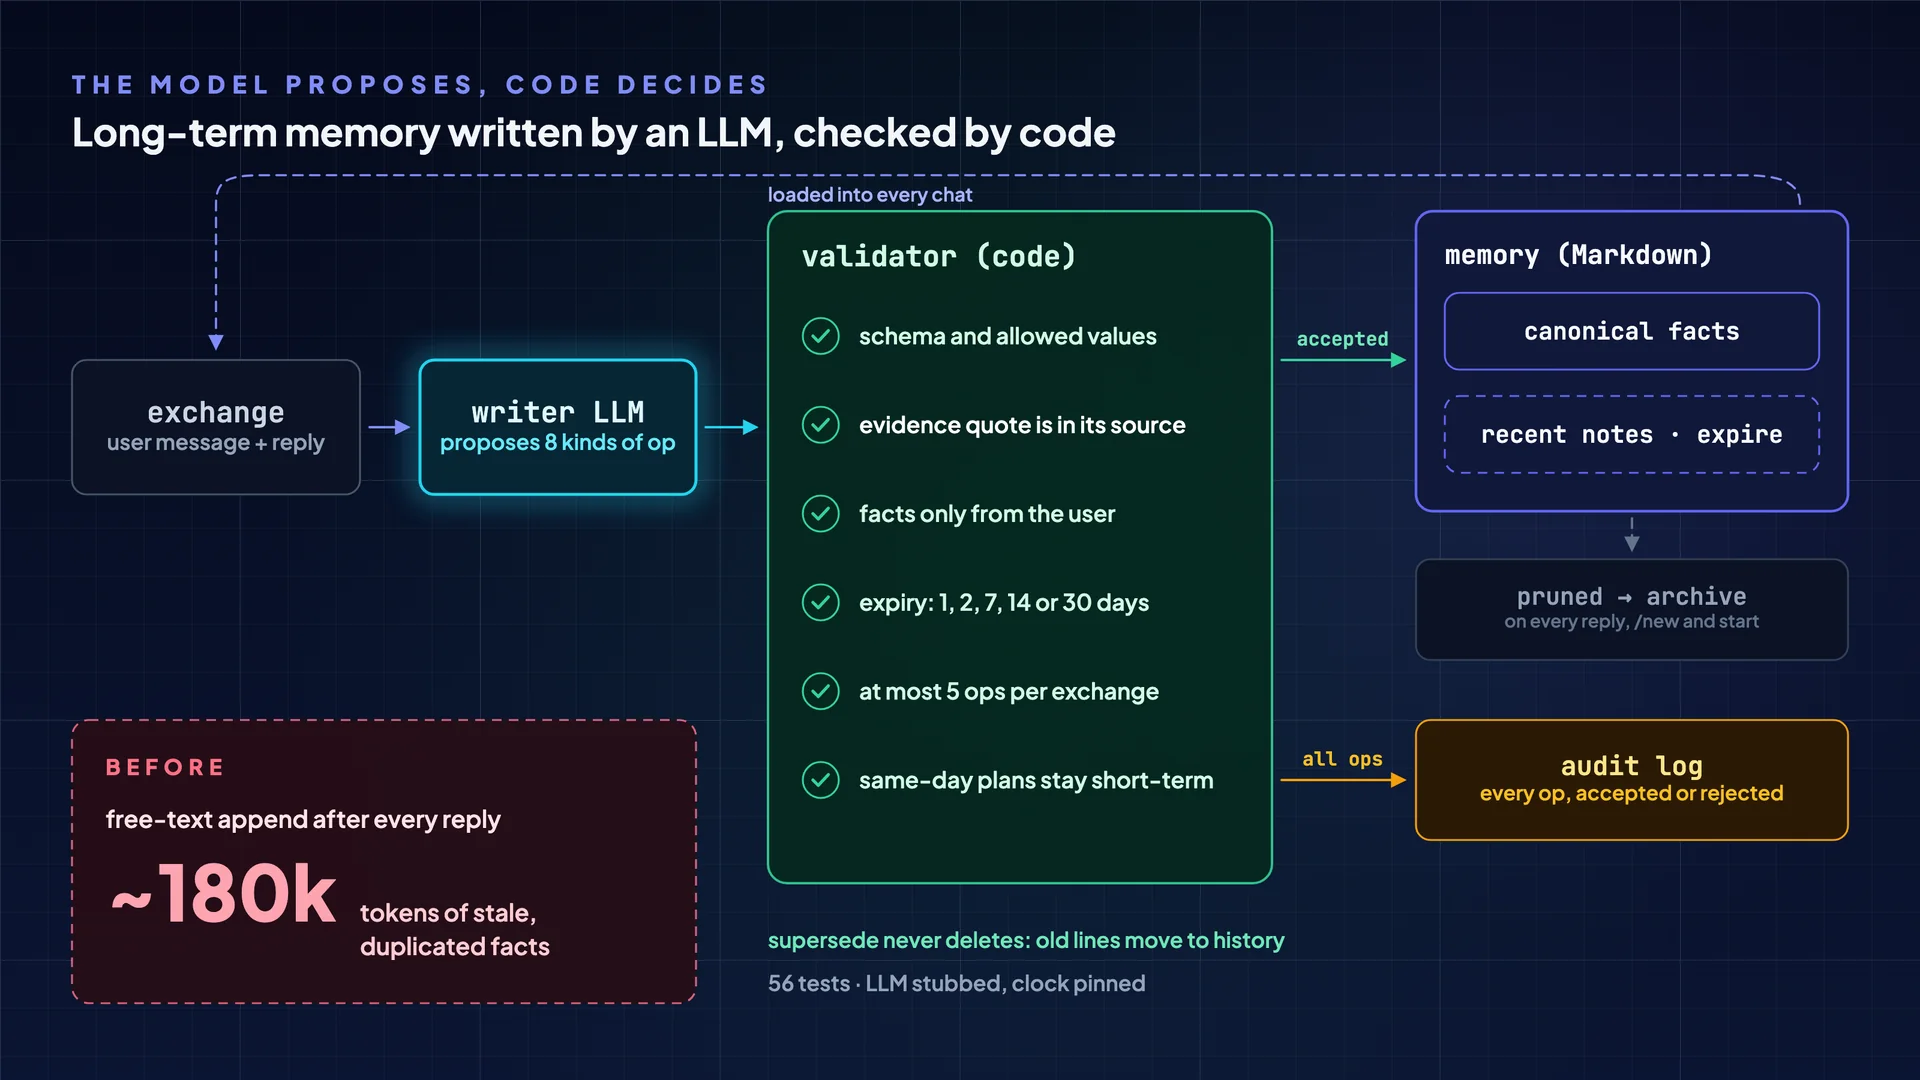
Модель предлагает правки памяти, а код сверяет каждую с разговором до сохранения.

~180 тыс. токенов
памяти в свободном тексте заменено
Обмен сообщениями идёт в LLM-писателя, затем в валидатор с шестью проверками, затем в файл памяти с каноническими фактами и истекающими заметками; каждая операция попадает в журнал аудита. Раньше: дописывание свободного текста, около 180 тыс. токенов.Открыть схему в полном размере

Задача

Мой Telegram-бот-коуч хранит долгосрочную память о пользователе. В первой версии модель дописывала свободный текст после каждого ответа. За два месяца ежедневного использования память, которая подгружается в каждый ход, выросла примерно до 180 тыс. токенов устаревших и повторяющихся фактов, а небольшая модель-экстрактор часть из них выдумала.

Почему это было сложно

  • Пишет память тоже LLM, поэтому её вывод меняется от запуска к запуску.
  • Нужно отличать то, что сказал пользователь, от того, что предложил ассистент.
  • Планы на сегодня не должны становиться постоянными фактами, а ошибки незаметно накапливаются месяцами.

Что я сделал

  1. 1Модель предлагает типизированные JSON-операции с цитатой-доказательством. Код принимает операцию, только если цитата есть в сообщении, на которое она ссылается, факты исходят от пользователя, срок хранения 1, 2, 7, 14 или 30 дней и операций не больше 5 за обмен.
  2. 2Файлом владеет код: канонические факты плюс недавние заметки, которые истекают и уходят в архив. Замена факта ничего не удаляет.
  3. 3Каждая принятая или отклонённая операция попадает в журнал аудита. Сначала я проверил идею офлайн на 12 реальных диалогах, затем пересобрал память, прогнав через новый механизм историю чата.

Результаты

~180 тыс.
токенов свободного текста до переписывания
8 / 5
типов операций; не больше 5 за обмен
56
тестов, с заглушкой вместо LLM и зафиксированными часами

Кто что делал: Полностью мой проект (66 из 66 коммитов), сделан с ИИ-агентами для кода.

PYTHONTELEGRAM BOT API

Истории из практики

Покороче: симптом, причина и исправление.

Синхронизация LLM

Пять ночей ложных «синхронизация не удалась»

Причина
Ночная синхронизация знаний шла через прокси с таймаутом 600 с, а индексация на другой стороне завершалась примерно через 22 минуты. Я подтвердил это по трём журналам: конфигу прокси, логу прокси во время запусков и логу агента.
Исправление
Обходить прокси для этого хоста и сохранять в каждом запуске собственную сводку агента «добавлено / удалено». Это заодно выявило «успешные» запуски, после которых индекс две недели не менялся.
Синхронизация LLM

Каждое сохранение запускало 40-минутную переиндексацию

Причина
Любая правка в базе знаний запускала полную переиндексацию (40–45 минут на агента, PDF разбирались заново), правки во время запуска ставили в очередь новые, а индексация блокировала единственный цикл событий агента, и чат ждал до 8 минут.
Исправление
Индексировать только при изменении сохранённого отпечатка корпуса, держать не больше одного повторного запуска, пропускать PDF с неизменёнными байтами и вынести индексацию из цикла событий. Синхронизация без изменений теперь занимает 0 с, а фид и индекс совпадают полностью.
Эксплуатация LLM

Самая быстрая модель на деле не отвечала

Причина
В бенчмарке на 10 запросах одна модель казалась в четыре раза быстрее остальных. Её ответы были пустыми: API отклонял параметр temperature, и таймер измерял ошибки.
Исправление
Проверять ответы, а не только время. Кешируемая проверка возможностей каждой модели заменила жёстко заданный список моделей. Реальный итог: медианная задержка 38,9 с → 9,0 с с моделью, на которую мы перешли.
День запуска

Исправление, которое поймал только мой телефон

Причина
В день запуска у партнёра примерно каждое пятое сканирование возвращало ошибку сервера. Сложились две ошибки: падение на пустом результате детекции лица и ответ «переснимите фото», собранный из 8 значений, когда код после обновления модели читал 9.
Исправление
Воспроизвёл на одноразовой копии и выкатил исправление по одному процессу из 31. Проверка на моём телефоне показала, что ошибка осталась: виджет узнаёт только один точный текст ошибки. Второе исправление его повторило, и следующие три дня успешно прошли 95% сканирований.
Релизы · ИИ-агент

git pull для тестовых агентов уронил продакшен на 33 минуты

Причина
Мой ИИ-агент для кода подтянул новый код для тестовых агентов в checkout, из которого работали и агенты продакшена (платформа ещё не запущена). Один модуль разбирает собственный исходник на каждом запросе, поэтому файл на диске перестал совпадать с кодом в памяти, и каждый чат получал 500.
Исправление
Я заметил это и откатил checkout, в тот же день написал постмортем и дал каждому окружению свой клон кода с откатом через симлинки. Эндпоинт версии теперь показывает реально загруженный код.
Сети в Go

Импорт, который ломался только через прокси

Причина
Клонированный HTTP-транспорт Go сохранял «h2» в TLS-рукопожатии, и клиент говорил по HTTP/1.1 с сервером, ожидавшим HTTP/2. Вдобавок CDN изображений присылал GOAWAY примерно на 2 000-м потоке, и ночной импорт обрывался на середине.
Исправление
Закрепить HTTP/1.1 для этого клиента, повторять запросы и пропускать одно битое изображение, а не валить весь запуск. Импорт каталога идёт в одной транзакции, поэтому сбой не оставляет ничего применённым наполовину.

Исследования

Публикация · 2024

Quantum annealing in machine learning: Qboost on D-Wave quantum annealer

Цитирование

15цитирований в Google Scholar

Рецензируемая статья о квантовом отжиге и машинном обучении, развивающая мою бакалаврскую ВКР (я второй автор, первый — Хади Саллум). Ансамбль в духе QBoost сформулирован как задача QUBO и запущен на квантовом отжигателе D-Wave. Рассматривается, когда квантовое железо дополняет классические ML-конвейеры, как ставятся эксперименты на реальном устройстве и как интерпретировать результаты с учётом ограничений чипа.

  • Связка квантового отжигания и ML: постановка QBoost на оборудовании D-Wave с понятной экспериментальной частью.
  • На стыке QC и ML — актуально в исследованиях и прикладных задачах.
  • Растущий список цитирований, включая ссылку в npj Computational Materials (Nature Portfolio, 2026).

Издание: Procedia Computer Science (Elsevier), 2024

Исследование в магистратуре · 2026

Как мы опровергли собственный результат о грокинге

48–49% → 100%
точность на отложенных данных при изменении только скорости обучения

Вместе с соавтором Yazan Kbaili я изучал, могут ли четыре модели, обученные на непересекающихся половинах данных с функцией согласия на неразмеченных входах, обобщать модульное сложение при 50% обучающих данных, где одна модель застревает примерно на 12%. Наш промежуточный результат не воспроизвёлся: мой же рефакторинг дал дистиллированной модели другой оптимизатор и расписание, чем у базовых линий. Я нашёл причину и провёл контрольные эксперименты, меняя по одной переменной.

  • Пилоты 1–4 будто упирались в потолок 48–49%. Изменение одной только скорости обучения даёт 100% примерно за 70 тыс. шагов.
  • Вариант с InfoNCE от соавтора достиг 92,2%, но менял шесть настроек сразу. С его рецептом одна лишь функция потерь KL-softmax даёт 100% примерно за 18,5 тыс. шагов.
  • Все запуски на одной GPU Kaggle T4, серии по 4–9 часов.

Ещё сделал

Go · PocketBase · 2024

Push-кампании

Кампании по топику, условию или списку пользователей: запись о доставке для каждого устройства, уникальность пары «кампания + устройство», рассылка и смена статуса в одной транзакции, единственный отправитель и пробные отправки (dry run) в первые две недели.

Python · 2024

Сервис-монитор с выбором лидера по Raft

Собственная реализация выбора лидера из Raft (сроки, случайные таймауты, голосование большинством, heartbeat): сервисы проверяет и шлёт алерты в Telegram только лидер, а состояние проверок передаётся в heartbeat.

React → Svelte · 2025–26

Встраиваемый виджет ассистента

Один тег script на сайтах партнёров: закрытый shadow root для кнопки и iframe для чата, чтобы CSS сайта не мог их сломать; иврит справа налево; типизированные сообщения между пятью окнами.

Демо виджета
SSE · 2026

Потоковые ответы

Server-sent events, читаемые через fetch, со сторожем зависания на 45 секунд. Черновик приходит потоком, а итоговый ответ заменяет его на месте; оборванный поток никогда не отправляет вопрос дважды.

Как я работаю

Сначала измерить

Тесты качества до переписывания, нагрузочные тесты до масштабирования, контрольный тест, воспроизводящий гонку, до исправления.

Модель предлагает, код решает

Вывод LLM проходит проверки в коде (id, которые вернули инструменты, цитаты-доказательства, жёсткие лимиты), а не вторую модель, которая чистит за первой.

Устранять класс ошибок

Причина по логам, постмортем в тот же день и изменение, которое закрывает весь класс: отдельные клоны для релизов, сохранённые отпечатки, регрессионные тесты.

ИИ-агенты с ограничениями

Каждый день работаю с Claude Code и Cursor. Я пишу план и правила, проверяю каждое изменение и сам выкатываю продакшен. Инцидент по вине агента заканчивается постоянным правилом.

Нужен инженер бэкенда или AI-платформы?

Я открыт к инженерным ролям, в том числе с релокацией, и к удалённым контрактам. Напишите — пришлю резюме.