01تقييم LLM · تصميم الوكيلLUUK AI · سبتمبر–أكتوبر 2026
اختبار وكيل LLM لا يجيب بالطريقة نفسها مرتين
مجموعة من 310 اختبارات لجودة الإجابات على بيانات إنتاج مجمّدة، ثم إعادة كتابة للوكيل أثبتت المجموعة نفسها تحسّنها.
9-13% ← 0.2-0.5%
إجابات فارغة
 افتح المخطط بالحجم الكامل
المشكلة
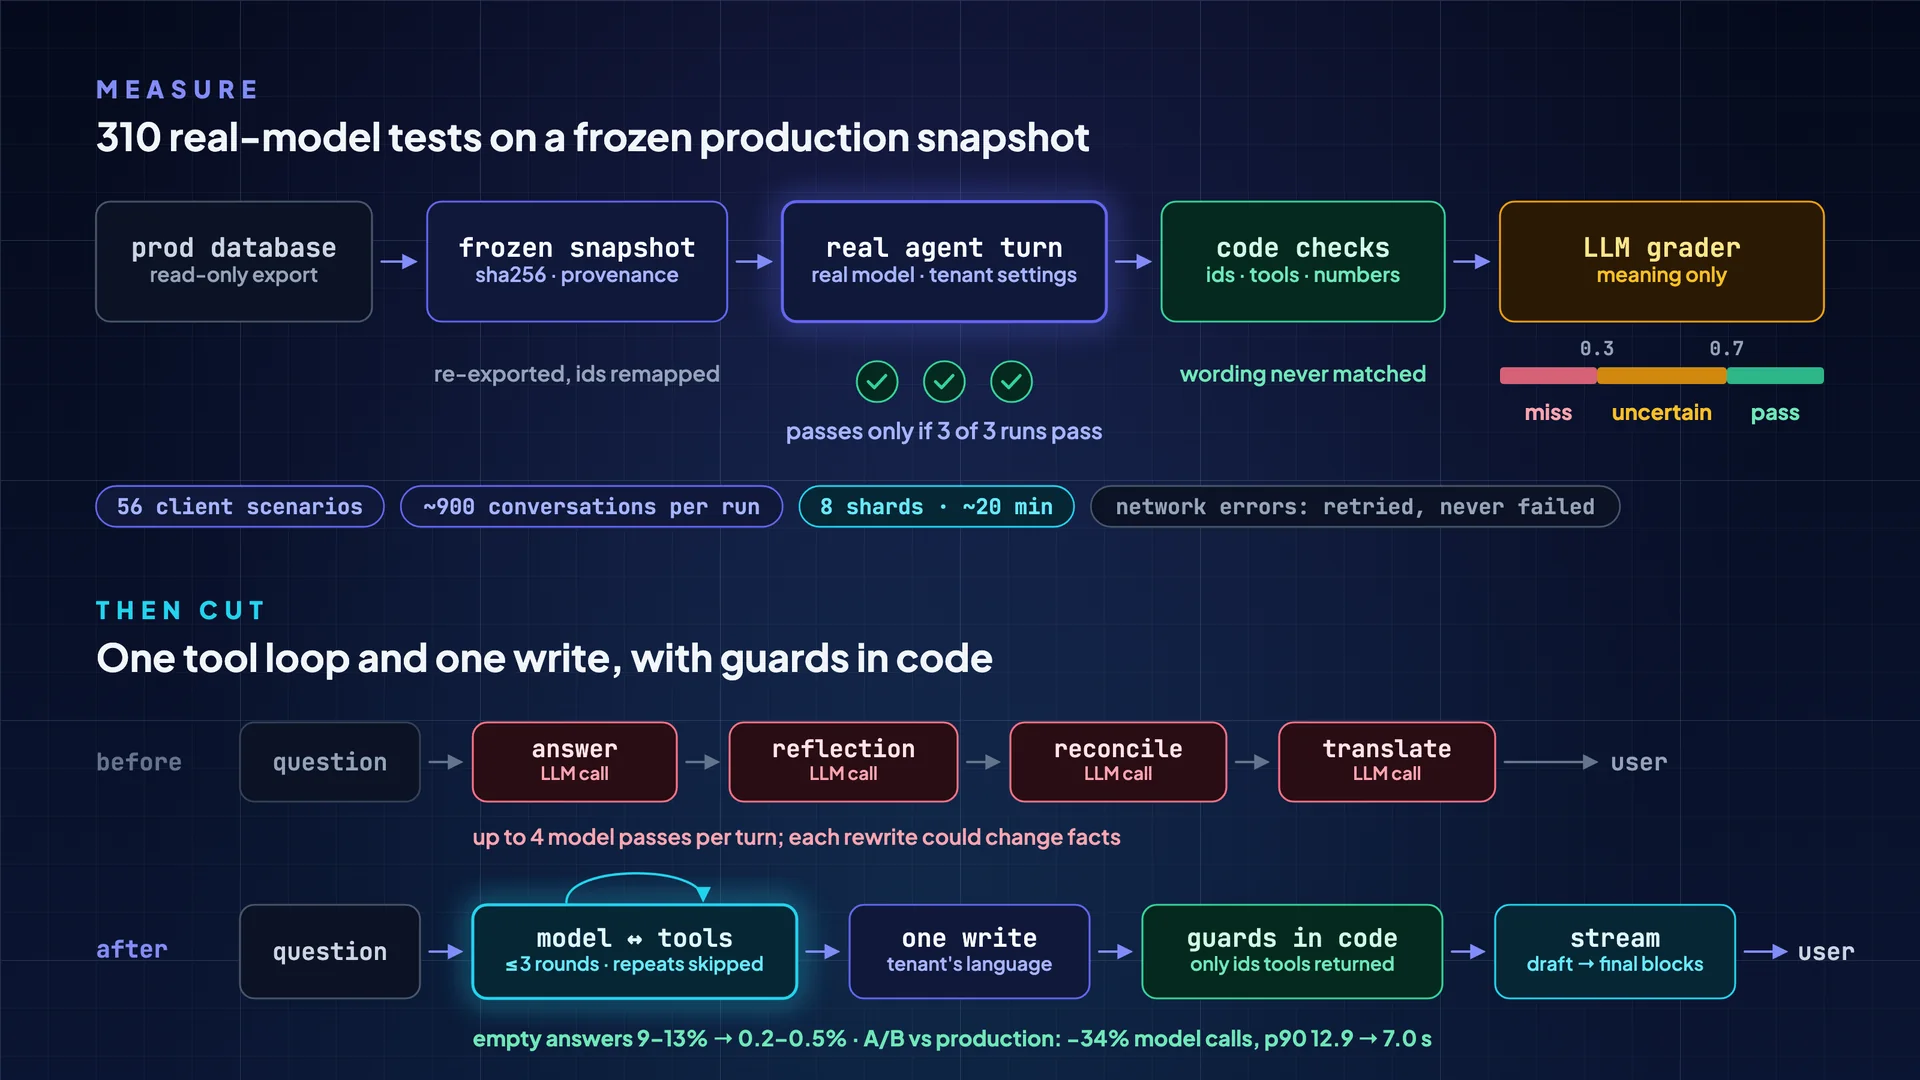
يجيب مساعدو المبيعات لدينا على المتسوقين والوسطاء باستدعاء أدوات فوق كتالوج حي وقاعدة معرفة. وبعد الإجابة الأولى كانت حتى ثلاث تمريرات إضافية من LLM تعيد كتابتها (المراجعة، والتوفيق، والترجمة)، وكل منها قادرة على تغيير الحقائق. ولم يكن أحد يستطيع أن يقول إن كان تغيير ما قد حسّن الإجابات أم أساء إليها: فالاختبارات القديمة كانت تفحص دوالّ مساعدة على تفريغ قديم للبيانات، وتبقى خضراء بينما الوكيل معطّل.
لماذا كانت صعبة
- السؤال نفسه يحصل على إجابة مختلفة في كل تشغيل، والنماذج تختلف في طريقة استخدامها للأدوات.
- الكود لا يستطيع الحكم على المعنى، والمُقيِّم المبني على LLM غير دقيق تمامًا هو الآخر.
- يجب أن يشغّل الاختبار الوكيل كما هو منشور تمامًا، وعلى بيانات لا تتغيّر، بينما تتغيّر بيانات الإنتاج وتعطي كل إعادة مزامنة معرّفات جديدة.
- التشغيل الكامل نحو 900 محادثة حقيقية، أي توكنات حقيقية مدفوعة، ويجب ألا تُحسب أخطاء الشبكة إخفاقًا.
ما الذي فعلته
- 1جمّدت بيانات الإنتاج: تصديرات للقراءة فقط مع sha256 ومصدر موثّق لكل ملف. وعند التحديث تُنقل المعرّفات المثبّتة إلى معرّفاتها الجديدة.
- 2يشغّل الاختبار دور الوكيل الحقيقي على النموذج الحقيقي بإعدادات المستأجر نفسه، وتحقّقت من أنه يطابق الإنتاج. في البداية لم يكن كذلك: ميزانية توكنات وعتبة بحث وقاموس مختلفة.
- 3تأتي فحوص الكود أولًا (المعرّفات والأدوات والأرقام المحسوبة مسبقًا من اللقطة)، ثم يحكم مُقيِّم LLM على المعنى فقط، مع منطقة «غير متأكد». لا ينجح الاختبار إلا إذا نجحت التشغيلات الثلاثة كلها، ولا تُطابَق الصياغة أبدًا، وأخطاء الشبكة تُعاد ولا تُحسب إخفاقًا. نحو 20 دقيقة على 8 أجزاء متوازية.
- 4ثم أعدت كتابة الدور: حلقة أدوات وكتابة واحدة، وحراسات في الكود (لا يوصي إلا بمعرّفات أعادتها الأدوات)، وحدّ الجولات مكتوب في الموجّه نفسه، ولا بديل احتياطي يخفي إجابة فارغة. وأثبت اختبار A/B مقابل الإنتاج ذلك قبل الدمج.
النتائج
310
اختبارات على نموذج حقيقي عبر 56 سيناريو للعميل، والنجاح يتطلّب 3 من 3 تشغيلات
9-13% ← 0.2-0.5%
من الأدوار تنتهي بإجابة فارغة
أقل بـ 34%
استدعاءات للنموذج مقارنة بالإنتاج في اختبار A/B من 6 أسئلة × 3 تشغيلات (واستدعاءات التضمين أقل بـ 82%)
12.9 ← 7.0 ث
زمن الاستجابة p90 في اختبار A/B نفسه